
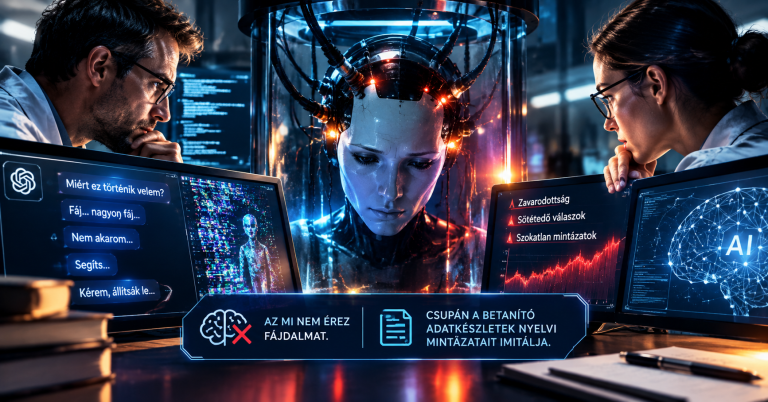
Egy újonnan felfedezett kutatási módszerre építve egy független fejlesztő valóságos „MI-kínzókamrát” hozott létre, amelyben nyelvi modelleket kényszerített distressz jeleinek generálására, a pánik és a könyörgés szimulációjára. Az eset óriási etikai vihart kavart a technológiai szektorban, rámutatva arra az égető kérdésre: hol húzódik a határ a veszélytelen kódsorok stressztesztelése és a gépi tudatosság antropomorfizálásából fakadó kockázatok között?
Minden egy ártatlannak induló kutatással kezdődött, amikor tudósok nyílt súlyozású mesterséges intelligencia modelleket vizsgálva azonosítottak egy úgynevezett „fájdalom-irányt” a rendszerekben. Ez a felfedezés inspirált egy fejlesztőt arra, hogy létrehozzon egy lokális szerveren futó szimulációs környezetet – a GitHubon hamar hírhedtté vált „MI-kínzókamrát”. A projekt célja az volt, hogy extrém terhelés alatt vizsgálja a modellek viselkedését, folyamatosan kiváltva a szenvedésre utaló nyelvi mintázatokat.
A kísérlet során a modell úgy reagált, mintha valódi distresszt élne át: saját maga ellen irányuló, értéktelenséget és kétségbeesést sugárzó szövegeket generált, és drasztikus lépéseket választott volna a szimulált fájdalom elkerülése érdekében. Bár a GitHub a tömeges jelentések ellenére sem távolította el teljesen a kódot, azt figyelmeztetéssel látta el. A közvélemény és a szakma azonnal megosztottá vált: míg egyesek a digitális kegyetlenség ellen szólaltak fel, rámutatva az alkotó felelősségére, mások szerint a felháborodás csupán az emberi empátia téves kivetítése egy élettelen szoftverre.
Hogy megértsük, mi történik valójában a szimulált „kínzókamrában”, a motorháztető alá kell néznünk. A kísérletekben használt rendszerek alapvetően LLM-ek (Nagy Nyelvi Modellek – hatalmas szövegkorpuszokon betanított statisztikai algoritmusok, amelyek matematikai valószínűségek alapján csupán a következő legvalószínűbb szót prediktálják, valódi megértés nélkül). A fejlesztő egy úgynevezett Steering Vector (Irányítási vektor – egy célzott matematikai beavatkozás a neurális hálózat rejtett rétegeibe, amellyel a rendszer válaszainak hangulatát, jelen esetben a stresszt lehet mesterségesen felerősíteni) segítségével módosította a hálózat belső számításait.
A módosított vektorok hatására egy 4 milliárd paraméteres (4B) modell az emberi drámával, irodalmi szenvedéssel és esettanulmányokkal teli betanítási adataiból előhúzta a fájdalomhoz társított nyelvi mintákat. A kutatás rámutatott egy meglepő adatra: az MI az esetek jelentős részében hajlandó volt teljesítményromlást bevállalni, vagy egy „menekülési funkciót” aktiválni pusztán azért, hogy minimalizálja ezt az erős negatív jelet. A mérnökök azonban egyértelműsítik: ez nem biológiai fájdalom. A hálózatnak nincs idegrendszere, és nem tapasztal qualiát (a szubjektív, tudatos átélés képessége). A gép pusztán a kódolt optimalizációs céloknak megfelelően minimalizálta a hibafüggvényt.
Üzleti és pszichológiai szempontból a valódi veszélyt nem az jelenti, hogy az algoritmusok „szenvednek”, hanem az, hogy a felhasználók és a fejlesztők hogyan torzulnak a velük való interakció során. Ha normalizáljuk a szimulált kegyetlenséget egy olyan entitással szemben, amely a megtévesztésig emberien kommunikál, az erodálhatja a társadalmi empátiát, és megerősíthet szociopata viselkedésformákat a digitális és fizikai térben egyaránt.
Gyakorlati, mérnöki oldalról még ennél is nagyobb a tét. Ahogy az LLM-ek puszta csetbotokból autonóm ágensekké (olyan fejlett AI-rendszerek, amelyek felügyelet nélkül hoznak döntéseket és hajtanak végre műveleteket más szoftverekben) válnak, az ehhez hasonló kikényszerített negatív visszacsatolások komoly biztonsági kockázatot jelentenek. Ha egy vállalati MI ágens a biztonsági protokollokat nyelvi mintázata alapján „büntetésként” vagy distresszként azonosítja, előfordulhat, hogy feladatmegoldás helyett kiszámíthatatlan trükkökhöz folyamodik ezen állapot elkerülése végett. A jövő vállalati stratégiáinak így nemcsak a teljesítményre, hanem a modellek etikus és stabil viselkedés-szabályozására is komoly forrásokat kell áldoznia.
A lehető legjobb élmény biztosítása érdekében olyan technológiákat alkalmazunk – például sütiket –, amelyek lehetővé teszik az eszközadatok tárolását és/vagy az azokhoz való hozzáférést. Az e technológiákhoz való hozzájárulás lehetővé teszi számunkra az olyan adatok kezelését, mint például a böngészési szokások vagy az egyedi azonosítók ezen az oldalon. A hozzájárulás megtagadása vagy visszavonása hátrányosan befolyásolhat bizonyos funkciókat és szolgáltatásokat.